27B、2.8T,这个 B 到底是什么?
模型圈的标题越来越像天书:27B、125B、2.8T。这个 B 到底是什么?它直接决定了你的显卡能不能跑得动这个模型。这篇用几个换算,把这件事彻底说清楚。
B 是什么:先学会数数
B 就是 Billion,十亿。在模型这里,1B = 十亿个参数。
换算速查
1B = 10 亿个参数
27B = 270 亿 125B = 1250 亿
1T = 1000B 2.8T = 2800B = 两万八千亿
每个参数就是一个数字,要占地方。刚开源的 Kimi K3 总参数 2.8T,是 27B 的一百多倍——不过它是 MoE 架构(混合专家),896 个专家里每个词只激活 16 个,所以「脑子大」不代表「每次都全用」。
文件多大?参数量 × 字节数
一个参数按 2 字节存(原版精度),一个 27B 的模型就是:
270 亿 × 2 字节 ≈ 54 GB
想变小?靠量化。量化就是降低精度,用更少的位数去存每个数字:
8 位量化 ≈ 27 GB,砍掉一半
4 位量化 ≈ 13.5 GB,只剩四分之一
同一个 27B:原版 54 GB,量化后十几 GB。代价是精度有损——但大多数场景下,4 位量化的效果依然够用。
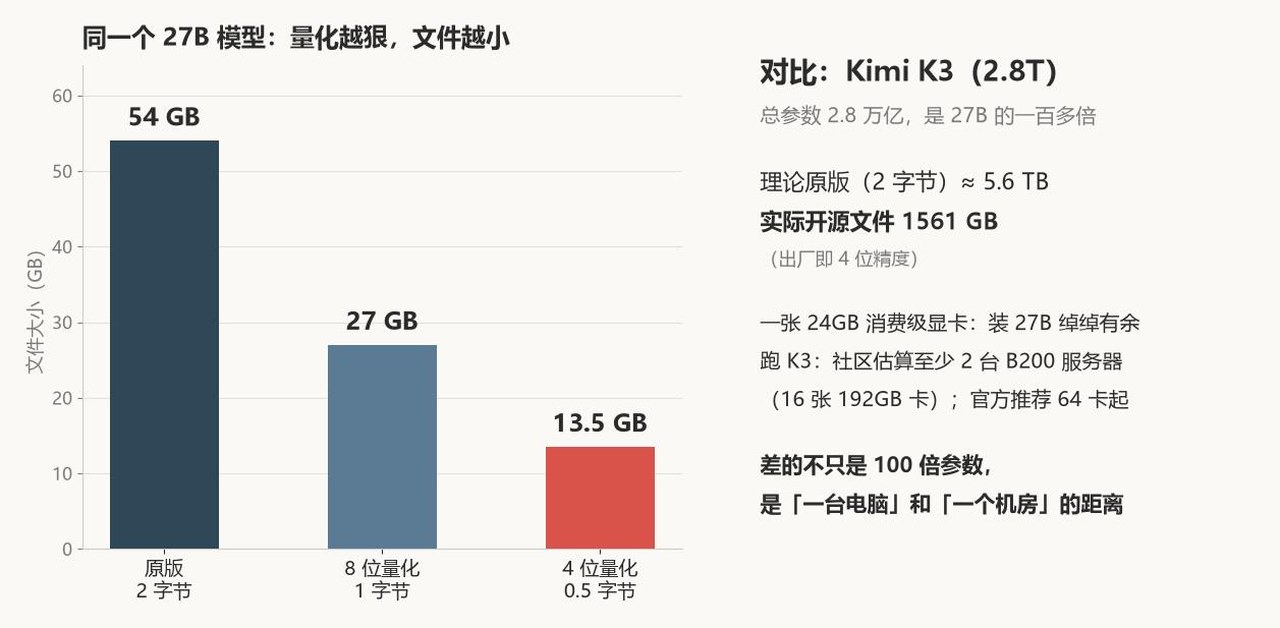
▲ 同一个 27B,量化前后差 4 倍;而 K3 的门槛,已经是「机房级」了。
文件多大,显存至少多大
模型要跑起来,权重得装进显存。所以文件多大,显存至少就得多大:
27B 4 位:13.5 GB → 一张 24GB 消费级显卡装得下
27B 原版:54 GB → 要 80GB 的专业卡
那 K3 呢?按 2.8T 算,理论原版要 5.6TB;实际开源文件是 1561 GB(出厂就带了 4 位精度),社区估算至少要 2 台 B200 服务器(16 张 192GB 的卡)才装得下,官方推荐的运行配置则是 64 卡起的超节点。
差的不只是 100 倍参数,是「一台电脑」和「一个机房」的距离。
显存装不下怎么办?借内存
今年爆火的开源推理引擎 Strata 给了另一条路:12GB 显存的显卡,跑一个总参数 125B 的模型(配套的 Qwen3.8-Flash-Next)。
它的底气是 MoE 的稀疏性:这个模型有 24,576 个专家,每个词只用其中 10 个。既然每次只用一小撮,就没必要把全部权重都塞进显存——让整机一起干活:
显存:放每个词都要用的公共部分,加上最常用的那几千个热点专家;
内存:放全部 24,576 个专家,没驻留显存的由 CPU 直接就地计算,和显卡并行;
硬盘:作为后备,存一张约 28.8GB 的查找表,按需读取。
有人在 RTX 3050(显存 7.7GB 可用)+ 68GB 内存上真跑起来了。显存的门槛降下来了,但内存的门槛抬高了——显存不够内存凑,内存不够硬盘补,总有一项要买单。
还要说清一件事:Strata 的「12GB 跑 125B」,是整机协同运行,不等于把 1250 亿参数全装进了 12GB 显存。而且这套玩法只对稀疏 MoE 有效——27B 这种稠密模型每个词都要过全部参数,借不来内存。
三步选型法
轮到你自己的机器,按这三步判断:
第一步:参数量 × 字节数 = 文件大小,先算出模型有多大;
第二步:装得进显存,就选精度最高的版本;
第三步:装不进,看内存够不够(MoE 类可以借内存),内存也不够就只能靠量化更狠的档位或更大的硬盘。
一句话总结:先显存,再内存,在装得下的前提下,选精度最高的那个。
注:文中 K3 的文件体积与硬件门槛来自其开源发布页与社区测算,Strata 的分工机制来自项目官方文档;各家更新很快,实际以官方说明为准。
免责声明:本文内容整理自公开网络内容,结合个人理解改写,仅作学习交流使用,相关结论仅供读者独立思考参考,请勿作为商业决策依据。版权归原作者所有,如有侵权请联系删除。
 湘公网安备43100302001132号